亞灣超算啟動 K-1 AI Factory 設計,以 800 VDC-Ready 架構迎接 Vera Rubin 時代
2026/09/16
亞灣超算已開始設計 K-1,一座位於亞洲、面向下一世代的 AI Factory 平台,整合 800 VDC-ready 電力架構、NVIDIA Vera Rubin 等級的基礎設施規劃,以及 Vertiv 800 VDC 配電系統。
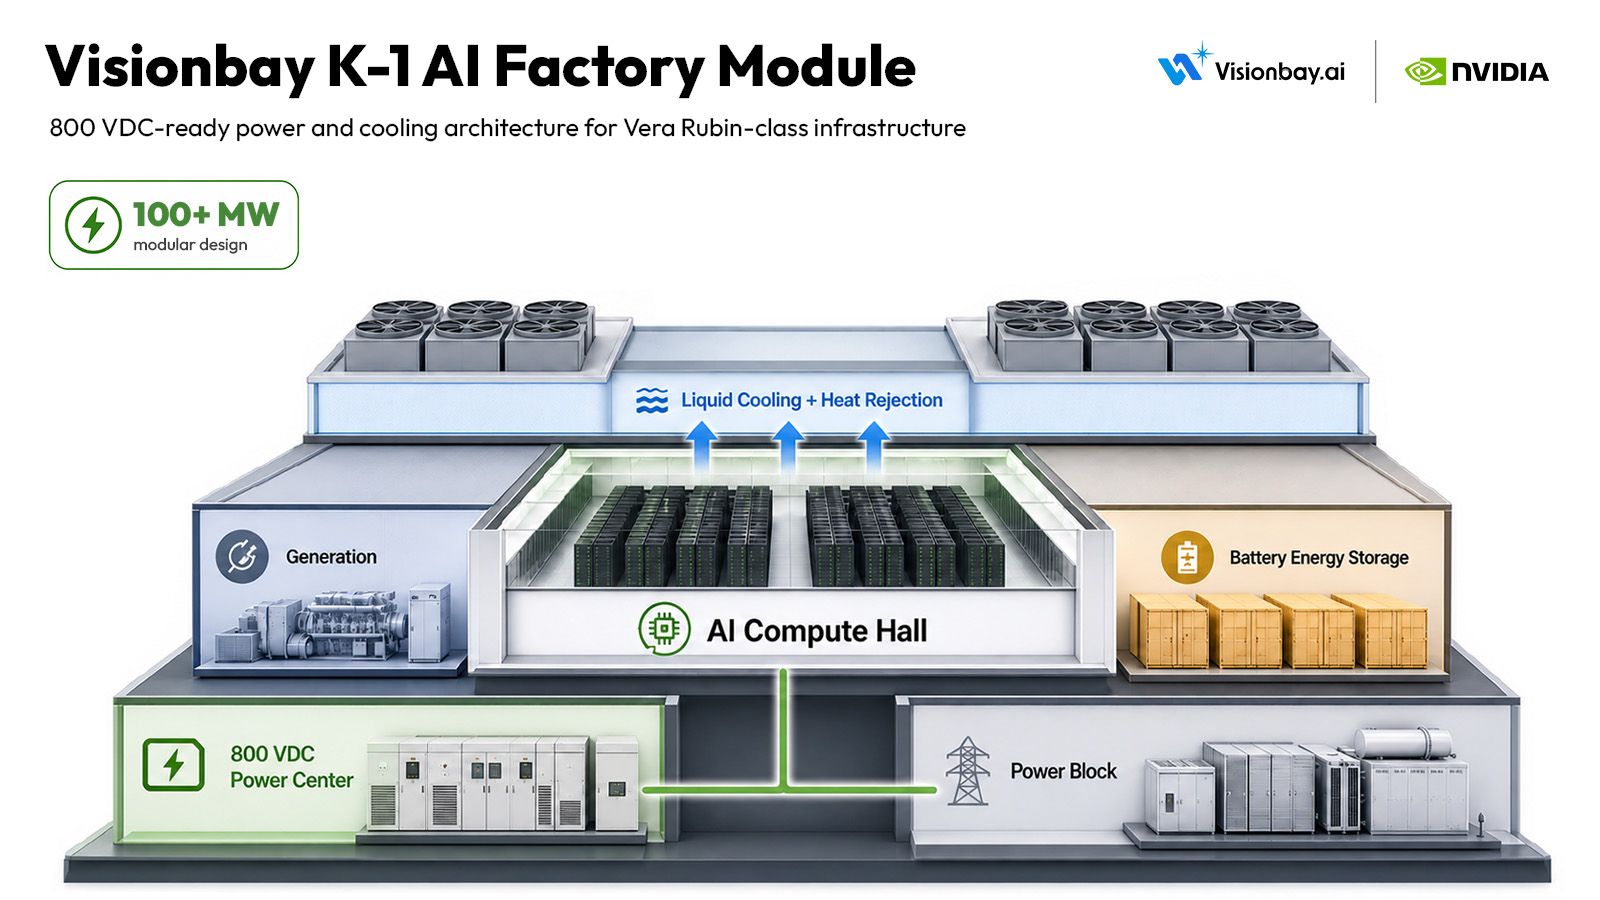 (圖說:亞灣超算的 K-1 模組概念,將 data hall、電力系統、發電系統、電池系統與冷卻基礎設施整合為可重複部署的 AI Factory 標準化建置單元。)
AI Factory 正逐漸成為智慧時代不可或缺的基礎設施。隨著企業、AI 實驗室與各國從實驗階段邁向大規模 AI 生產與應用,對加速運算的需求也正快速成長。這類設施並非傳統的資料中心,而是專門打造、用來將能源與資料轉化為智慧的工廠,支援推理模型、AI Agents、科學研究與數位服務。這項根本性的轉變,也意味著我們必須重新思考整體的設施設計。
K-1 的客戶價值主張
K-1 為資料中心營運商提供一條務實的過渡路徑,使現今採用交流電(AC)供電的 AI 系統,能逐步銜接至未來採用原生 800 VDC 架構的運算系統。此設計在保留近期部署彈性的同時,也能降低電力基礎設施閒置或提前淘汰、大規模改造造成營運中斷,以及未來機櫃功率密度受限等風險。
由於設施電力系統通常需要支援數個世代的運算平台,因此真正需要考量的,不只是「今天應該採用哪一種電壓」,而是如何建立一套具備長期使用價值的基礎設施基礎架構,使其能隨著運算技術發展藍圖持續演進,並支援未來更高密度的運算平台。
為下一世代 AI 而設計
AI 工作負載正快速演進。隨著訓練、微調與推論同步擴展,加上進階推理應用使每次互動所需的運算量持續增加,我們正面臨一個全新的基礎設施課題:每個機櫃需要更多運算能力、每平方公尺產生更多熱量,以及電力系統承受前所未有的壓力。
高密度 AI Factory 需要一套更具擴展性的供電方式。隨著機櫃功率密度持續提升,傳統的低壓配電架構將越來越難以擴展。高電流也會在線纜配置、銅材需求,以及電力轉換設備所占空間等方面帶來更多挑戰。
800 VDC 架構透過以較低電流傳輸更多電力來解決這些限制。這不僅能降低配電複雜度、支援更高密度的運算機櫃,也能在設施基礎架構與實際執行運算的 GPU 系統之間,建立一條更簡潔、更有效率的供電路徑。正如液冷已成為高密度系統不可或缺的技術,800 VDC 也正逐漸成為下一階段 AI Factory 設計的重要基礎。
對營運商而言,其潛在效益包括:提高可實際使用的電力容量、減少線纜與設備壅塞、為有效運算保留更多空間,以及降低公用電力來源與 GPU 之間的電力轉換階段。實際效益仍會取決於所採用的系統拓撲、設備配置、備援設計、保護策略與配電距離。
邁向 800 VDC 的務實路徑
K-1 的策略以務實性為核心。整體設施設計並非建立在單一且高風險的技術轉換之上,而是採取分階段遷移的方式。亞灣超算將在適當區域持續採用經過驗證的 AC 基礎設施,並隨著高密度 GPU 叢集的需求增加,在更接近運算負載的位置逐步導入 800 VDC。這使 K-1 能夠從現階段的部署方式,清楚地逐步過渡至未來的原生 800 VDC 機櫃架構。
透過採用 NVIDIA 的 800 VDC 參考架構,K-1 將導入 cluster-level Power Center architecture,把 AC-to-800 VDC 的電力轉換集中設置在運算叢集附近。這樣的彈性讓我們能優先在最能立即產生效益的區域部署 800 VDC,同時確保整體設施能隨著設備、認證要求與運算需求的演進,持續保有調整與擴充能力。
K-1 Cluster-Level Power Center 架構
K-1 將採用 Option B:cluster-level Power Centers,透過 800 VDC busways 與 tap cans,為多組運算機櫃提供電力。此架構可作為新建 AI pods 與分階段園區擴建時可重複使用的標準化模組,同時保留每個 Power Center 上游既有且經過驗證的中壓與低壓 AC 基礎設施。
- 可重複部署(Repeatable deployment) — 標準化的 Power Center 模組可先完成工程設計、工廠整合、驗證與試運轉,再作為 cluster 的標準 building block 進行部署。
- 平衡資本投入節奏(Balanced capital phasing) — 可依 cluster 逐步增加容量,使基礎設施投資能隨實際運算需求與公用電力準備程度分階段投入。
- 簡化下游配電(Simplified downstream distribution) — 透過集中式整流,減少在各機櫃層級重複配置 AC-to-DC 轉換設備,並將 800 VDC 配電位置拉近運算負載。
- 控制營運風險範圍(Bounded operational risk) — 每個 cluster 都維持明確的電力與維護範圍,可支援分區隔離、備援設計與維修規劃,同時避免形成整個 data hall 共用單一電力轉換系統的依賴。
為什麼「Ready」很重要:5G 的類比
從現有架構過渡至 800 VDC,其實與早期 5G 智慧型手機的普及過程相當類似。當第一批支援 5G 的手機進入市場時,5G 網路覆蓋率仍然有限;但消費者普遍相信更廣泛的 5G 服務即將到來,因此往往會選擇一台 5G-ready 的裝置,而不是購買一台等到 5G 網路普及後就需要汰換的設備。
資料中心營運商現在面臨的是一個相似、但規模更大、生命週期也更長的決策。運算平台可能每隔幾年就會更新一代,但設施電力基礎架構往往會持續使用數十年。所謂 800 VDC-ready design,並不代表 K-1 從第一天開始,每一個部分都必須以 800 VDC 運作;而是預先保留未來導入 800 VDC 所需的系統拓撲、設備空間、配電路徑、保護策略與冷卻介面,以便當商業需求與運算平台真正需要時,可以順利導入。其目的並不是為尚未使用的功能提前付出成本,而是要在不更換底層設施平台的前提下,保留銜接下一世代技術的能力。
與 AI 基礎設施生態系協作
沒有任何一家公司能夠獨力打造一座 AI Factory。K-1 專案是整個產業生態系深度合作的成果:
- NVIDIA:提供運算平台發展方向,以及規劃 Vera Rubin 等級基礎設施所需的參考架構框架。
- Vertiv:提供關鍵的熱管理基礎設施、電力系統,以及支援高密度液冷部署所需的實務工程專業。
這種以生態系協作為核心的方式,有助於降低設計上的不確定性,並為營運商、合作夥伴與供應商提供一套共同框架,用於驗證並擴展 AI Factory 的部署。
共同的架構框架也有助於擴大合格供應商的範圍。透過多家 OEM 共同參與,可提升製造產能、增加採購彈性、促進系統間的互通性,並降低對單一設備路線的依賴。這些優勢的實現,仍有賴於一致的介面規範、協調一致的驗證流程,以及明確的系統層級責任分工。
將電力與冷卻視為一個整合系統
K-1 從一開始就被設計為一套整合式 AI Factory 模組,而不是在傳統 data hall 建置完成後,才額外加入電力與冷卻系統。我們的設計將公用電力、變電站、電力模組、data hall、液冷系統、發電設備、電池系統,以及屋頂散熱系統整合到同一套協同規劃中。
主要設計元素包括:
- 分階段容量擴充(Staged Capacity Growth): 採用 22.8 kV 設施配電,並整合 800 VDC Power Center,以支援容量分階段成長。
- 分散式備援(Distributed Redundancy): 採用「4-to-make-3」電力設計理念,以支援專案目標可用性與不中斷維護需求。
- 整合式熱管理(Integrated Thermal Management): 結合屋頂式氣冷散熱系統與 Vertiv XDU 等級冷卻系統,以支援百萬瓦等級的熱負載。
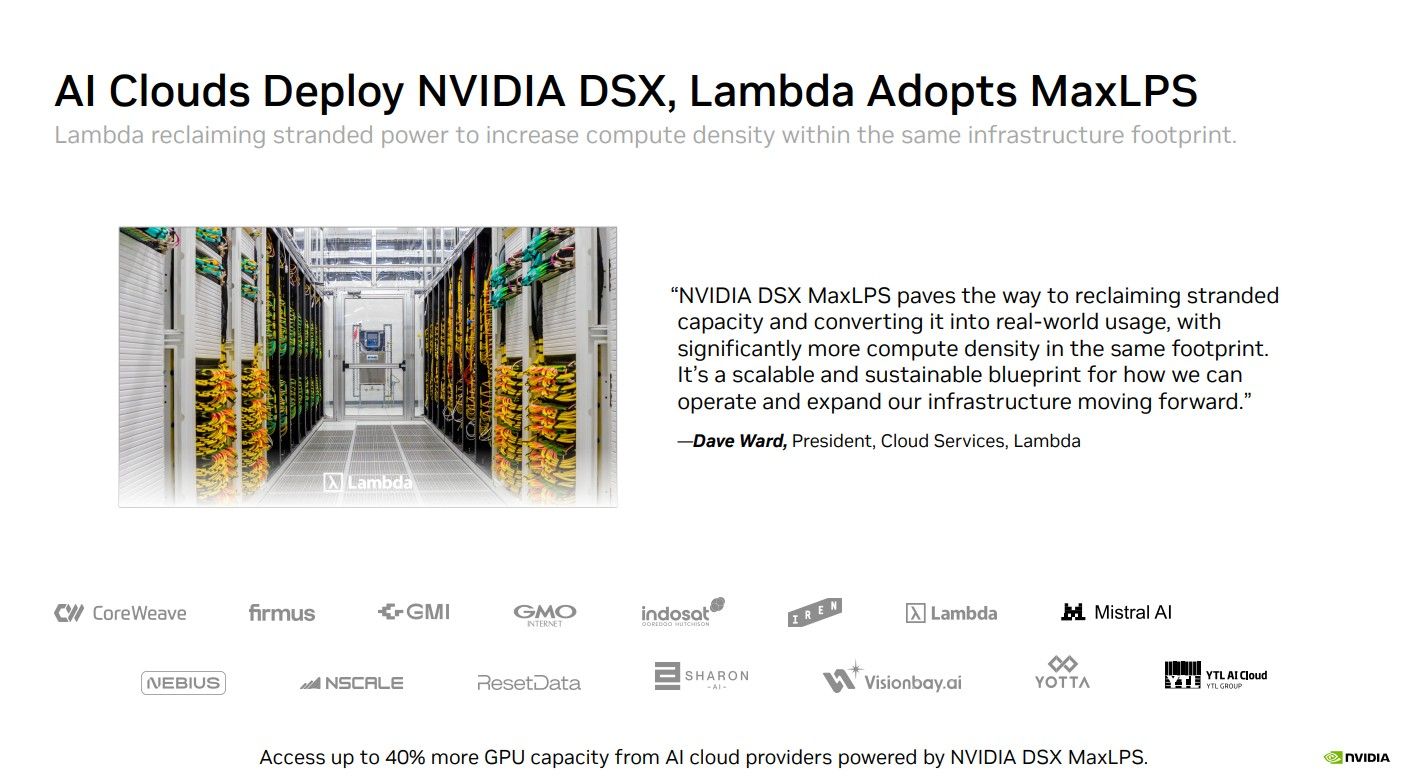
- 電力與運算最佳化(Power and Compute Optimization): 設施設計依循 NVIDIA DSX MaxLPS 的原則,在固定電力預算下,結合感知電力使用狀況的運算調度、高溫液冷與基礎設施層級效率,最大化 AI Factory 的每瓦效能。
對 Vera Rubin 等級的部署而言,液冷尤其關鍵,因為電力密度與散熱需求必須被視為一個彼此高度相依的整體系統來設計。
為實際部署而打造
下一階段的 AI 基礎設施,關鍵將在於營運卓越。K-1 的工程設計,目標是將高階的架構概念轉化為真正可部署的基礎設施,包括電力機房、冷卻迴路、busways 與維護通道。我們著眼於長期發展,打造能隨 GPU 平台、機櫃功率與液冷技術進步而持續演進的設施基礎。K-1 建立在以下幾項核心原則之上:
- 從第一天開始,即以高密度系統為設計目標。
- 透過分階段部署來管理風險,並配合公用電力準備進度。
- 將電力與冷卻整合為單一設施系統。
- 與 NVIDIA 的 AI Factory 架構指引保持一致。
- 與生態系合作夥伴共同加速整體就緒程度。
為 Vera Rubin 時代及更遠的未來做好準備
AI Factory 正逐漸成為產業環境中最具策略價值的資產之一。隨著 AI 更深入整合至生產流程,這些設施必須具備更高的可擴展性、效率與適應能力,同時跟上快速演進的運算技術藍圖。真正的挑戰,不只是提供更多電力,而是如何讓設施能支援一代又一代更高密度的運算平台,而不需要進行大幅且具干擾性的設施重新設計。
亞灣超算正以這樣的未來為目標設計 K-1。透過採用 800 VDC-ready 架構、與 NVIDIA roadmap 對齊,並與 Vertiv 等產業領導者合作,K-1 建立了一個可重複擴展的成長單元。
此架構可支援集中式電力轉換、明確界定的故障區域,以及一條可從現今運算系統逐步擴展至未來原生 800 VDC 機櫃的路徑。我們打造的,不只是一個新的電壓等級,而是一套能夠隨需求持續擴展、支援未來 GPU 世代,並協助合作夥伴將能源轉化為智慧的基礎架構。